Poznáváme DOM IV. — Procházíme dokument
V této části seriálu o specifikaci DOM se podíváme
na základní metody a rozhraní určené k procházení modelu, které definuje Core. Nejdříve budeme
muset opět vstřebat trochu teorie. Malá poznámka na okraj než začneme, všechny odkazy na rozhraní a metody
DOM vedou(pokud není uvedeno jinak) na specifikaci
DOM Level 2 Core.
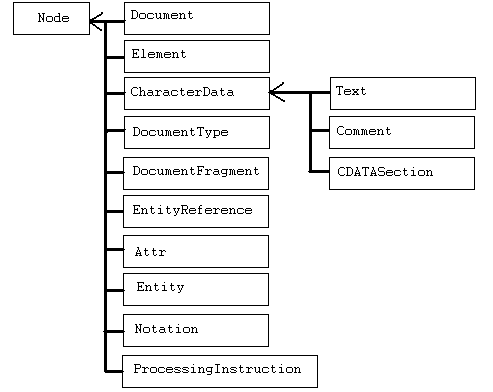
DOM reprezentuje dokument jako hierarchii objektů implementujících základní
rozhraní Node
a také další mnohem specifičtější rozhraní. Specifická rozhraní jako například Element nebo Document
jsou potomky rozhraní Node. Následující obrázek vyjadřuje
hiearchii rozhraní modulu Core
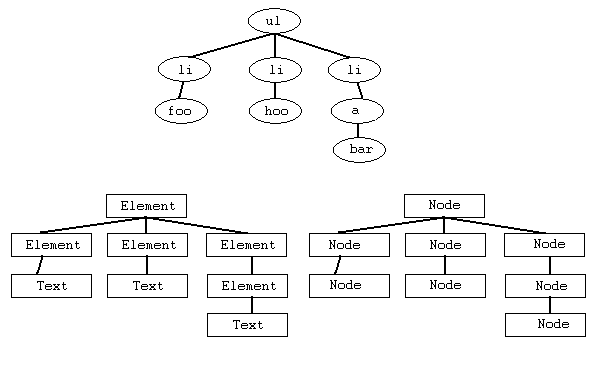
Podívejme se na následující část kódu
- foo
- hoo
- bar
Tyto elementy si můžeme představit jako strom objektů. Každý objekt je navenek prezentován specifickým rozhraním. Jak
již víme všechny rozhraní jsou přímým nebo nepřímým potomkem rozhraní Node a proto
si můžeme všechny uzly představit pod tímto rozhraním, jak ukazuje následující obrázek.
Základní metody pro získání části dokumentu
Po hříchů to jediné co mnoho lidí považuje za DOM jsou metody
getElementById(id Elementu) a
getElementsByTagName(jméno tagu) definované
rozhraním Document. Tyto metody opravdu patří mezi
úplně základní, ale rozhodně nesmíme zapomenout na další metodu tohoto rozhraní getElementsByTagNameNS(jmenný prostor, jméno tagu),
která se hodí při práci s XML dokumentem.
Použití metod getElementById(id Elementu) a getElementsByTagName(jméno tagu) je tak všeobecně
známe a používané, že uvedu pouze krátké náznaky jejich použití.
HTML:
	bar.com

   JavaScript:

    	  function underLine(status){
	    element = document.getElementById("foo");
	    element.style.textDecoration = (status)?"underline":"none";
	  }
Pokud není element se zadaným id nalezen, vrací metoda hdnotu null. Pokud je v dokumentu
více elementů se stejným id, vrací metoda první z těchto elementů. V případě tolik používané náhrady
document.getElementById = document.all se metoda v případě více shodných id chová tak, že
vrací jejich kolekci. Uvádím proto jednu z možných náhrad metody getElementById za použití kolekce all.
if (!document.getElementById){
     document.getElementById =
	   new Function("idname",
                        " kolekce_prvku=document.all(idname);
			  if (kolekce_prvku==null) return null;
			  if (kolekce_prvku.length)return document.all(idname)[0];
			  return document.all(idname);
                        ") ;
  }
Další jednoduchý příklad ukazuje využití metody getElementsByTagName(jméno tagu) pro
nastavení atributu target u všech elementů a.
HTML:
	bar.com
        bar.com

   JavaScript:

    	  elements = document.getElementsByTagName("a");
	  for(foo = 0; foo < elements.length; foo++){
	    elements[foo].target = "_blank";
	  }
Metoda vrací objekt typu NodeList,
který představuje kolekci vybraných elementů.
Tímto bychom dnešní povídání ukončili, na příště si povíme o procházení dokumentu pomocí metod, které
nabízí Node
a naznačíme možnosti, které nabízí modul Traversal.
Dnešní příklady lze otestovat na testovací stránce getElementsByTagName
a testovací stránce getElementById.
Související články
- (Dagblog 4.1.2004) Poznáváme DOM I
- (Dagblog 5.1.2004) Poznáváme DOM II. — struktura dokumentu a objektový model
- (Dagblog 12.1.2004) Poznáváme DOM III. — moduly a úrovně
- (Dagblog 29.1.2004) Poznáváme DOM Poznáváme DOM IV. — Procházíme dokument
- (Dagblog 24.2.2004) Poznáváme DOM Poznáváme DOM V. — Procházíme dokument II.
Související články
Související epizody CZ Podcastu
- #217 · Ivo Lukačovič
O Windy, JavaScriptu a budování firem.
- #3 · Java 6 SE, Vývoj webových aplikací
Dagi a Filemon o novinkách v Javě 6 a webových frameworcích.