Neznáme neznámo
Minulý týden jsem vyrazil do Jihlavy na setkání místní Google User Group, původně jsme s organizátory lavírovali mezi tématy, která oscilovala od monitoringu po naší firemní kulturu v Zonky. Nakonec jsem se shodli na tom, že bude nejlepší klouzat trochu po povrchu a vysvětlit koncept, pomocí kterého se snažím řídit celý vývoj. Trochu s odstupem času mi došlo, že jsem tohle nikdy nikde jinde neříkal, kromě pár zmínek v podcastu či dílčích vystoupení na různých meetupech. Celé nahlížení na to jak vést softwarový vývoj v mém případě ovlivnily tři zásadní knihy. Dvě knihy — skoro bych řekl až filozofické traktáty — Nasima Nicholase Taleba s názvem Černá labuť a Antifragilita, a jedna kniha z pera T. Nygarda s názvem Release It. Moje přednáška v Jihlavě se jmenovala Black swan engineering a koncept Černé labutě stojí v epicentru vývoje a ovlivňuje vše.
Až do roku 1697 věřili občané starého světa, že všechny labutě na světě jsou bílé. Před 321 lety tahle víra vzala za sve když Wilem De Vlamingh přistál u břehů Austrálie a uviděl černou labuť. Všechna pozorování bilých labutí do té doby podporující teorii, že všechny labutě jsou bílé, vzala jediným opačným pozorování za své. Fenomén Černých labutí popisuje vysoce nepravděpodobné událostí, které mají zásadní dopad. Černé labutě mají tři základní atributy.
- Jsou vysoce nepravděpodobné, leží mimo hranice očekávání (někdy jim říkáme outliers)
- Nelze je dopředu předpovědět přestože se nám retrospektivně zdají naprosto nevyhnutelné
- Mají zásadní dopad/význam
Z pohledu historie byl černou labutí například rozpad Sovětského svazu, vypuknutí První světové války a nebo 11. září 2001. Rád bych řeč stočil zpět k problému pozorování labutí.
V knize je ještě jeden krásný příklad: rybáři několik let krmí kapry v rybníce. Kapr se má každý den lépe a lépe. No a když se těší, že další den bude ještě lépe, tak skončí na talíři u štědrovečerní večeře. Pozn. pro české reálie jsem zaměnil krocana za kapra.
Pokud se ptáte, jak sakra souvisí kapr, krocan či jiná havěť souvisí se softwarovým vývojem, zkusím to vysvětlit.
Vývojový cyklus má několik základních více či méně formálních fází — analýza, vývoj, testování a release. Zákazník, uživatel či konzument se k výslednému produktu dostane až po fázi releasu.
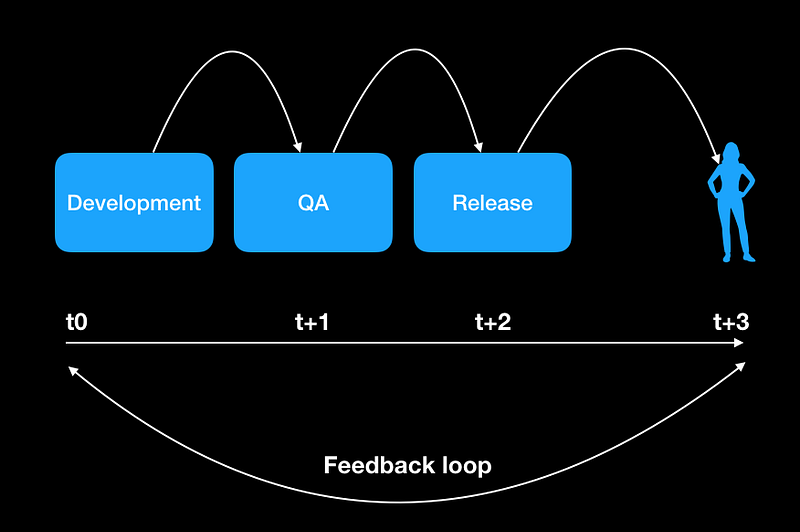
Tradiční přístup k zlepšení tohoto cyklu je zaměřit se a dávat důraz na fázi analýzy, vývoje a testování. Více času se stráví u rýsovacího prkna ve snaze přinést lepší analýzu, navrhnout propracovanější architekturu a nebo dát vývojářům do rukou lepší nástroje nebo programovací jazyky, případně vrhnout více lidí a prostředků do testování.
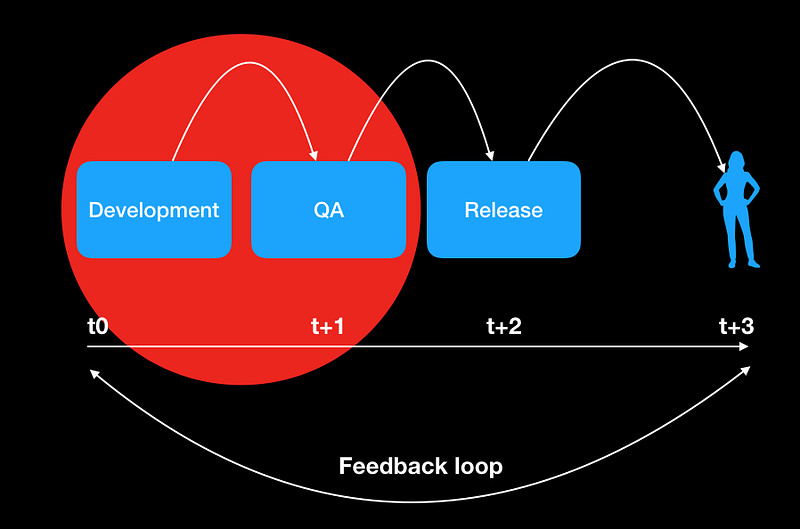
Bohužel tento přístup zdokonalování není úplně efektivní pokud tedy přímo neselhává kvůli efektu Neznámého neznáma. Náš rozhodovací model je postaven kolem toho co víme (známé známo) případně víme, že nevíme (známé neznámo). Abych to vysvětlil na příkladu vývoje tedy přesněji řečeno testování.
- Známé známo, víme co máme otestovat, typicky se jedná o předem sestavené test cases na základě popisu funkcionality resp. očekávání, jednotkové vycházející ze znalosti implementace.
- Dále máme známé neznámo, víme že něco určitě nevíme, pro to máme integrační testy, provádíme exploratory testinga nebo pouštíme zátěžové testy.
- Třetím do party je neznámé neznámo, tedy to co nevímé že nevíme, a je to něco co nikdy nemáme šanci otestovat.
Jak s oblibou říká Petr Melgr: otestovat můžeme jenom to co můžeme otestovat.
Touto geniální větou přesně vyjádřil podstatu neznámého neznáma. Neznámé neznámo se projeví teprve ve chvíli kdy se kód objeví na produkci a dostane se do styku s reálným uživatelem. To co nevíme je mnohem důležitější než to co víme, proto tomu musíme svoji pozornost zaměřit na pravou část celého vývojového cyklu. Tam se totiž neznámé neznámo projeví.
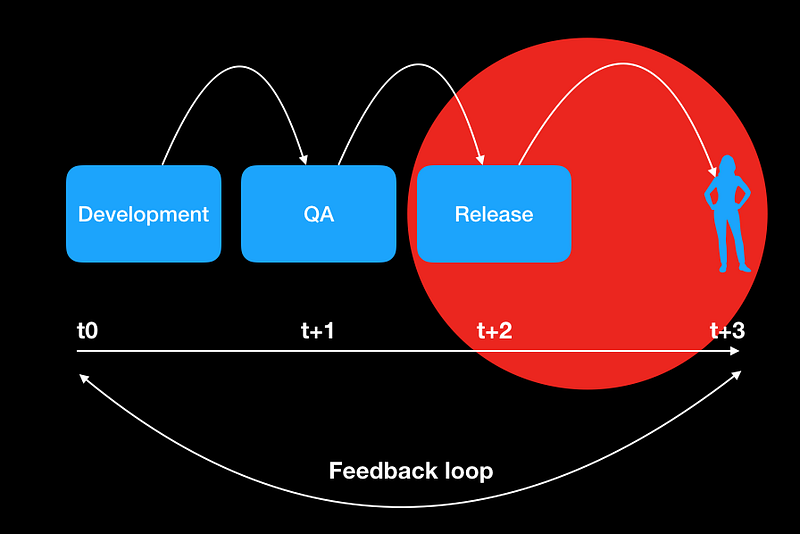
Co to znamená zaměřit se na pravou část vývojového cyklu? Předně, pokud se nějaký problém objeví, je potřeba ho umět absorbovat. My máme oddělený proces nasazení od fáze rolloutu uživatelům. Snažíme se používat takzvané feature toggles , pomocí kterých řídíme kdy a kolika uživatelům se daná funkcionalita vystaví.
Používáme interní telemetrii, podle které měříme jak daná funkcionalita funguje či nefunguje. Kromě Google analytics máme data v DWH. Kromě toho se snažíme zkracovat feedback loop, OODA princip. K tomu nám slouží bezvýpadkové releasy (naše continuous delivery pipeline překřtěná z Fast track na Fofr track), díky kterým dokážeme nasazovat změny několikrát denně.
Se zkráceným feedback loopem dokážeme mnohem lépe reagovat nejenom na neznámé neznámo, ale neplatit zbytečné náklady za vylepšování funkcionality, která není tolik používaná. Samozřejmě to znamená, že product owners nesmějí podléhat svodům toho, že naplánují práci na měsíce dopředu, ale snaží se vše ořezat až na dřeň v podobě MVP a zároveň vývojáři musí počítat s tím, že optimalizace a mazlení s kódem nastává až ve chvíli kdy má reálné uživatele.
Neříkám, že části vývojového cyklu, která předchází release a provoz se nevěnujeme, ale velkou část našeho úsilí se snažíme napřít právě na oblast, ve které se projeví neznámé neznámo a za které pochází černé labutě.
Související články
Související epizody CZ Podcastu
- #261 · Leadership
O vedení lidí a týmů.