Technické ohlédnutí za rokem 2017
Na začátku roku 2018 jsme se sešli v coworkingu K10, abychom se trochu ohlédli za rokem 2017 a zhodnotili co se nám povedlo dosáhnout v Zonky v technické oblasti.
Přetočte pásku
Každé ohlédnutí musí nutně začínat na začátku roku 2017. My jsme v té době byli po první fázi rozšiřování našeho týmu. Ještě na podzim 2016 za celým Zonky stálo 5, slovy pět, vývojářů. Na začátku roku 2017 už nás bylo šestnáct.
Takovýto růst sebou přinesl celou řadu problémů. Veškerá technická znalost byla koncentrovaná v Brně, ale tým rostl v Praze. Velmi brzo se rovněž ukázalo, že čím více vývojářů máte, tím více máte režie.
Code review se ukázal býti úzkým hrdlem neboť nutné znalosti měli pouze dva vývojáři. K tomu se nám pod nohy neustále pletla neplánovaná práce — opravy chyb, změny na poslední chvíli — s přívlastkem včera bylo pozdě. Náš release cyklus byl nastaven na deset dnů a release procedůra byla manuální do té míry, že jsme kopírovali příkazy z Confluence. Měli jsme pouze základní telemetrii o běhu systému na úrovni základních prostředků operačního systému (CPU, pamět, disk, síť) a jenom jeden nebo dva velmi základní aplikační healtchecky. Náš deployment se rozprostíral na jednom virtuální hostu, kde běžela databáze, aplikační server a HTTP server dohromady.
První věcí, kterou jsme udělali, byla reorganizace, která měla za cíl:
- rozložit klíčové vědomosti přes více týmu, přestože to znamenalo distribuované týmy. Tři vývojáři z Brna se stali součástí týmů Alfa, Bravo a Charlie (názvosloví podle Navy Seals týmů, máme přece nejlepší vývojáře).
- dedikovat 1/3 naší vývojové kapacity na neplánovanou práci. Neplánovaná práce získala rovněž svůj dedikovaný backlog a způsob zadávání byl přes Service Desk (příjemnější uživatelské rozhraní pro běžné uživatele) namísto JIRA. Pokud vás to zajímá, můžete si přečíst koncept zametacího týmu.
- rozšířit gatekeepery (právo mergovat pull requesty) o vývojáře pomocníky, kteří zvládnou ulevit od části jednodušších pull requestů.
Desetidenní cyklus nás vystavil do problému v případě, že se release z různých důvodů ocitl v ohrožení. V takovém případě by odložení o dalších deset dnů znamenalo obrovské riziko při testování vzhledem k velkému počtu změn. Znáte to, víc vývojářů. víc kódu nebo chcete-li změn. Přestože jsme na to nebyli technicky připraveni (manuální release) zvedli jsme kadenci releasů na týdenní frekvenci If it hurts do it more often. Náš release proces se nám podařilo vylepšit na několika frontách.
- manuální kopírování příkazů z Confluence nahradila procedura kompletně přepsaná do Chefu a později do Ansible.
- zároveň jsme investovali do bezvýpadkových releasů, které umožňují nasadit určitý typ změn bez výpadku systému. To si samo o sobě zaslouží samostatný článek.
- post release verifikaci, kterou jsme dělali manuálně, nahradily alespoň z části smoke testy
- u některých produktových novinek, například sekundární trh, jsme oddělili fázi nasazení od fáze rolloutu uživatelům pomoci feature toggles skrze službu LaunchDarkly
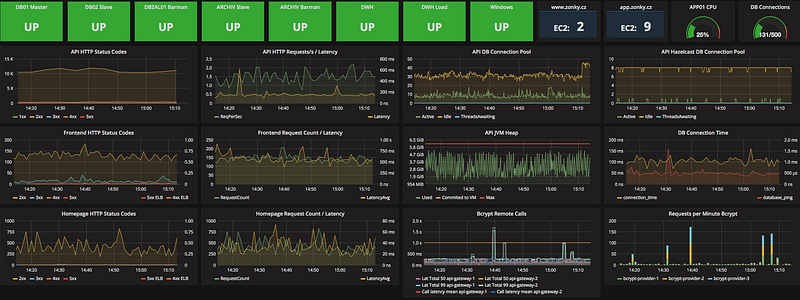
Vhled do běhu systému přineslo vylepšené monitorování a dohled. Aplikační logy putují do Splunku, kde je můžeme prohledávat během troubleshootingu. Máme v něm nastavené základní alerty, typicky pro bussinesové operace, které měly nastat a nenastaly nebo selhaly a objevují se v logu— zpracování bankovních transakcí, reporting smluv apod. Aplikační metriky (pomocí CodaHale metrics)a metriky operačního systému se ukládají jako time series do InfluxDB a vizualizujeme je pomocí Grafana. Veškeré healtchecky, jejíchž počet se významně rozrostl, kontrolujeme pomocí Icinga 2. K real time monitoringu JVM a k troubleshootingu výkonnostních problémů používáme v produkci službu New Relic.
Všichni vývojáři začali držet jednou za pár týdnů pohotovost přesně podle hesla You build it You run it. Základní přehled o stavu systému je vidět na operačním dashboardu.
Určitý typ testů a vývojářských use cases jsme přenesli do Dockeru. Kdokoliv si může kdykoliv nastartovat novou instanci Zonky v Dockeru z libovolné větvě v Gitu. Zároveň jsme všechny testovací prostředí zmigrovali do AWS a pár jsme jich přidali, abychom byli schopni testovat na prostředí, které je topologicky co nejblíže produkci a zároveň ho můžeme kdykoliv obnovit.
Často jsme využívali dynamické škálování v AWS, kdy jsme například zdesetinásobili počet instancí pro Jenkins či Docker v závislosti na potřebách vývojářů. Kapacita se nafukovala a vyfukovala podle potřeby, to vše nad spot fleet instancemi, které mají výrazně příznivější cenu (80–90% sleva).
Jeden z velkých problémů, kterému jsme čelili, byly výpadky Zonky v případě lukrativní půjčky na tržišti. Do detailu jsem to popisoval v tomto článku. Nakonec jsme opět využili dynamického škálování, tentokrát na zbytkovou kapacitu v datovém centru. S příklonem k architektuře mikroslužeb jsme řešili API gateway (postaveno nad Netflix Zuul), která se stala centrálním bodem pro každy HTTP požadavek, který teče dovnitř systému. Více se o toho API gateway dozvíte v tomto videu.
Všechny mikroslužby (zatím do deseti kusů) běží v HA módu a kvůli bezvýpadkovému nasazení jsme museli revidovat všechnu aplikační logiku kvůli re-try požadavků. Právě bezvýpadkové nasazování bylo jednou z velkých infrastrukturních oblastí, které jsme se věnovali. Přestože se to zdá jako vývojářské téma, bylo to spíše o governance a úpravě procesu vývoje, který má jiný flow.
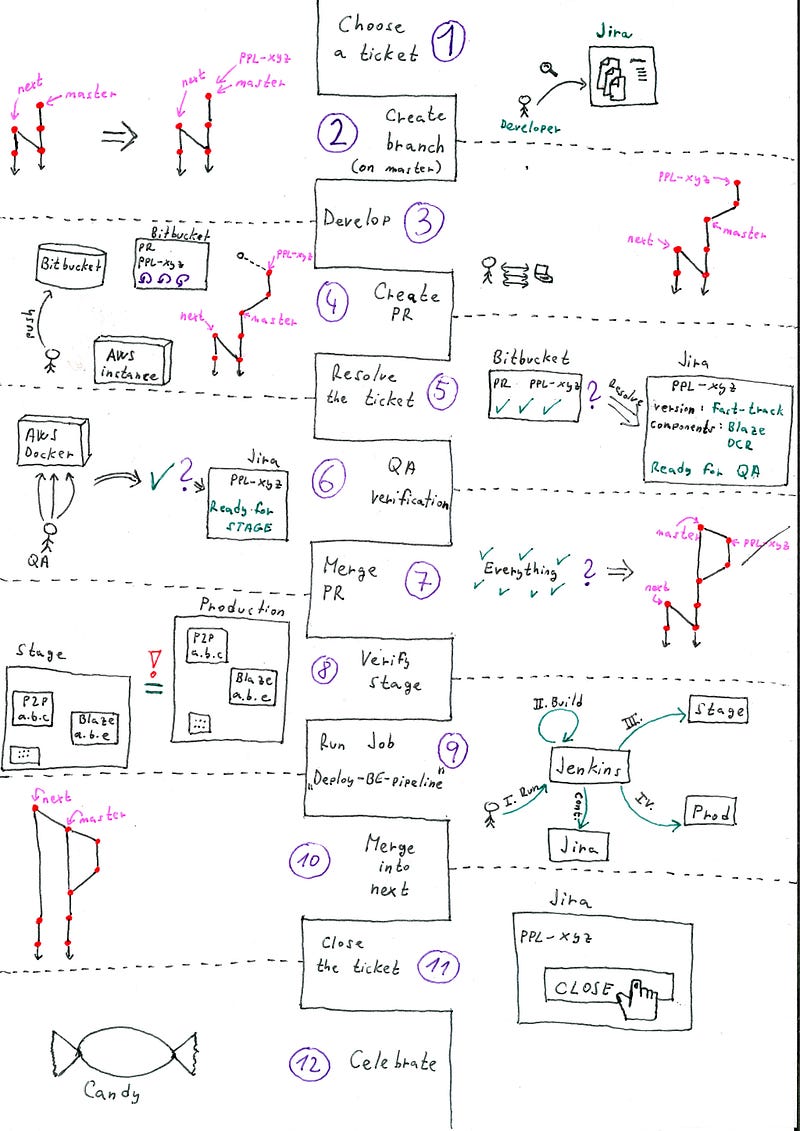
Všechny služby běží nad Spring Boot a Spring Cloud, to nám umožňuje používat celou řadu infrastruktury v podobě Spring Cloud Config serveru a nebo komunitního Spring Boot adminu.
Jednou z velkých oblastí — a zdrojem problémů samozřejmě — byl přepis z Angular.js do Ember.js, který si zaslouží samostatný článek. K tomu jsme se rozhodli přistoupit kvůli potřebě server side renderingu (SEO). Deployment frontedové části aplikace jsme vytvořili v AWS nad Elastic Beantalk s optimalizací v podobě CDN (CloudFront).
V mezičase jsme náš backendový deployment setřepali — díky pomoci našeho hosting providera S1 — do jednoho datového centra a to včetně fyzického přestěhování baremetal stroje s produkční databází. Kromě toho nás jako blesk z čistého nebe zasáhla mobilní aplikace a její vývoj. Na backendu to znamenalo prošťouchnutí několika technologií včetne Spring REST doc (REST testy jako dokumentace API), Spring Cloud Contract (kontraktové testy)a další Spring Cloud Netflix knihovny, abychom mohli vystavit speciální API ušité přímo na míru mobilní aplikaci.
Určitě jsme na spoustu věcí zapomněl, ale i tak si myslím, že to je úctyhodná přehlídka toho co se nám v roce 2017 povedlo.
Pro rok 2018 jsem jako cíl vybral zlepšení a automatizaci našich testů s ohledem právě na bezvýpadkové releasy. Chtěl snížit kadenci našich výpadkových releasů (na 21) a nahradit je bezvýpadkově. Kromě toho nás čeká další růst týmu a s tím související radosti a strasti. V oblasti infrastruktury nás čeká Kubernetes a pro back office rozhraní přechod na Angular 4.
Mimochodem stále hledáme posily do Prahy a Brna. Více o naší kultuře napoví náš engineering blog případně pár starších rozhovorů.
- https://www.zonky.cz/zonkytimes/praci-si-musim-zakazovat-rika-martin-pavlik-v-zonky-propojuje-byznys-s-it/
- https://www.zonky.cz/zonkytimes/je-to-daleko-narocnejsi-ale-to-je-ta-spravna-vyzva-rika-chirurg-ze-zonky/
- https://www.zonky.cz/zonkytimes/na-baby-sitting-nejsme-vybaven-ani-mentlne-ani-rychlost-rk-f-vvojru-v-zonky/
- https://www.zonky.cz/zonkytimes/bavi-me-ze-delame-veci-pro-skutecne-lidi-rika-vyvojar-zonky-lukas/
Související články
Související epizody CZ Podcastu
- #261 · Leadership
O vedení lidí a týmů.