Testování na produkci
V puritánských světě tradičního vývojového kolečka s charakterem vodopádu je samotná myšlenka testování na produkci do nebe volajícím rouháním. Nebo není? Testování na produkci neznamená žádné testování, naopak se jedná o velmi sofistikovaný přístup k testování, které probíhá s reálnými daty a živými uživateli. Ve světě agilního přístupu, mikroslužeb a cloudu je testování na produkci nikoliv jednou z možností, ale nezbytností. Samotné testování pouze dílkem celé skládanky doručování software, nabízím proto širší pohled na celou problematiku.
Motivace
Předně je to nutnost daná zkracujícím se vývojovým cyklem a požadavky na agilitu. Vyjádřeno v nákladech, je to poměr mezi tím co investujete do vývoje versus to co vám to přinese když to dostanou do rukou uživatelé. Velká část produktového vývoje stojí na hypotézách — tu více a tu méně podpořených uživatelským průzkumem a testováním — které si ověříte právě až ve chvíli kdy je přetavíte do produktu, který dáte uživatelům.
Pokud mám hypotézu, že věrnostní program mi s náklady X přinese Y nových zákazníků, jediná možnost k reálnému ověření spočívá v tom, že ten věrnostní program uděláte. Věrnostní program se dá udělat za týden, měsíc, půl roku, je to jenom o tom jak dokonalý si ho přejete mít. Čím déle to trvá, tím více do toho investujete zdrojů a tím více oddalujete moment, kdy to dostanou do rukou uživatelé a vy uvidíte, jestli funguje podle vašich předpokladů či nikoliv.
V produktovém vývoji se proto snažíte postupovat v malých krůčcích a rychle si validovat hypotézy až do chvíle kdy dává poměr cena-výkon smysl. Testujete businessově na uživatelích a to musí zohlednit délka vývojového cyklu. Pokud potřebujete změnu minimálně každý týden nemůže trvat vývojový cyklus měsíc ani čtrnáct dnů. A tomu musí odpovídat technické testování.
Překážky zkracování vývojového cyklu, proč to nejde rychleji
Když jsem pracoval na vývoji “krabicového software”, trval vývojový cyklus od původní analýzy, vývoje, testování až po vypálení CD nosiče několik měsíců. Změna byť jednoho jediného bitu znamenala nejenom absolvovat půlku toho martyria znova, ale nesla sebou logistické problémy pokud jste nemohli distribuovat jenom záplaty. Byla to prostě noční můra.
S GoodData v oblasti software jako služby (SAAS) a Zonky v oblasti fintechu se vývojový cyklus dramaticky zrychloval až k týdnu. Umožňovala to nejenom povaha produktu/služby, ale především kontrola nad celým řetězem od návrhu, vývoje přes nasazení až po distribuci ke koncovému zákazníkovi. Přesto další zkracování vývojového cyklu na dny nebylo dost dobře možné výjma případů s horkým záplatováním produkce v případě závažných incidentů.
Bránily tomu tři omezení. Ty samy o sobě představují problém, ale — a to je mnohem horší — jsou vzájemně provázané a tvoří uzavřeném kolečku příčin a důsledků.
Mindset lidí
Většina IT managementu je tvořena bývalými vývojáři, kteří mají zažitý určitý způsob vývoje. Ten byl ušitý právě na míru krabicovému vývoji a nákladnosti se změnou byť jednoho jediného bitu a velikosti změn, které každá nová verze přinášela. Jeho těžiště se nalézalo v testech ať již automatizovaných nebo manuálních, které měly tvořit barieru proti regresním chybám.
Vystoupit z této komfortní zóny pro ně bylo složité. Shrnul bych to větou, “dělali jsme to tak přece vždycky”. Často tomu mohly bránit procesní překážky, kdy vývojový proces byl jenom jednou z dílků ve skládačce, která byla ohraničena regulatorními či legislativními předpisy. Změna byla možná, ale přesahovala pravomoc vývojového týmu. Bylo potřeba sladit marketing, prodej, legal&compliance oddělení, prostě každého kdo v celém soukolí participoval. Jestliže to bylo složité pro samotný IT management nebo dokonce pro vývojáře, pro tahle oddělení to byla často utopie.
Samozřejmě to šlo dělat jinak, stačilo koukat kolem sebe. Příklady představovaly firmy Facebook, Google, Netflix či Amazon. Poukazování příkládů na jejich službách často končilo, a dodnes končí, námitkou “tam když se něco pokazí, tak se nic neděje”. Tuto námitku mužeme jednoduše odmítnout na příkladu největší digitální samobsluhy na světě — Amazonu. Tam by se tedy sakra něco dělo kdyby se přestaly zpracovávat objednávky třeba během Černého pátku. Prostě námitka kdo chce psa bít, hůl si vždycky najde.
Takto nastavený přistup tvořený neochotou či nevědomostí vystoupit z komfortní zóny od shora dolů tvoří hlavní překážku zkracování vývojového cyklu.
Testy, jejich typy a prostředí
Zkracování rovněž bránily typy testů. Nemluvím pouze o manuálních testech, ale především o automatizovaných testech. Páteř testů v podobě end to end integračních testů je nejenom časově náročná na provedení, ale složitá na údržbu a často velmi křehká. Není nic horšího než flaky testy, které degenerují důvěryhodnost celé sady, pokud nejste Google, který si s tím poradí po svém.
Nejsou to jenom testy, které jsou drahé na údržbu, ale i sdílená prostředí, na kterých dochází k jejich spouštění. Sdílená prostředí hrají důležitou roli, protože co je sdílené o to se málokdo stará. Proto vznikají specializovaná oddělení nebo se určují vlastníci, kterým se to hodí na hrb. Čím více prostředí (dev, test, integration, uat, pre-prod) tím více hardware, software-licencí a údržby. Přestože jsme v Zonky využívali všech výhod veřejného cloudu (AWS) včetně spot fleet instancí a škálování během vývojových špiček v pracovní době tvořil účet za nevývojovou infrastrukturu největší nákladovou položku.
Prostředí jsou nejenom velikostí, ale často i topologií vzdálené od toho co máte na produkci. Ja to trošku jako v tom Babicovo receptu: pokud nemáte limetku, dejte tam cintrón a pokud nemáte citrón nedávejte tam nic. Na produkci máme sice Redis cluster, ale na prostředích se používá in-memory cacheování v JVM, aby to bylo levnější a snazší na správu.
Změnit páteř testů a tím pádem zredukovat testovací prostředí naráží nejenom na náklady, ale i na mindset lidí a architekturu viz předchozí bod a následující bod.
Architektura a velikost změn
V monolitické architektuře sebou nese každá změna nutnost nového nasazení aplikace jako celku. Zároveň se všechny změny na konci vývojového cyklu smíchají dohromady. Výsledná změna je obrovská a je nutné otestovat prakticky všechno neboť nelze dost dobře izolovat dopad změn a k nim odpovídající sadu regresních testů. Selhání jedné části monolitické aplikace může vést k selhání celé aplikace (nasazované jednotky). Tato hrozba vede na další typy testů, které potřebují další typy prostředí a jsme v začarovaném kruhu.
Techniky testování produkci
Důležitým faktorem, který umožňuje posunutí testování do produkce, představují technické možnosti, jenž máme k dispozici v oblasti nasazení (deploy) změn a rolloutu (zobrazení) změn, a architektura aplikací.
Deploy versus Rollout
Zatímco dříve deploy a rollout byla často jedna fáze, kdy se nasazená změna okamžitě promítla všem uživatelům, dnes jsou to fáze dvě. Dříve novější verze balíčku nahrazovala starší verzi balíčku, existovala vždy pouze jedna verze. Cloudové aplikační stacky (např. AWS Beanstalk) nebo Kubernetes umožňují několik strategií nasazení např. nasadit novou verzi aplikace a na ní postupně přesměrovat veškerý provoz ať již ve formou canary releasu nebo blue-green deploymentu.
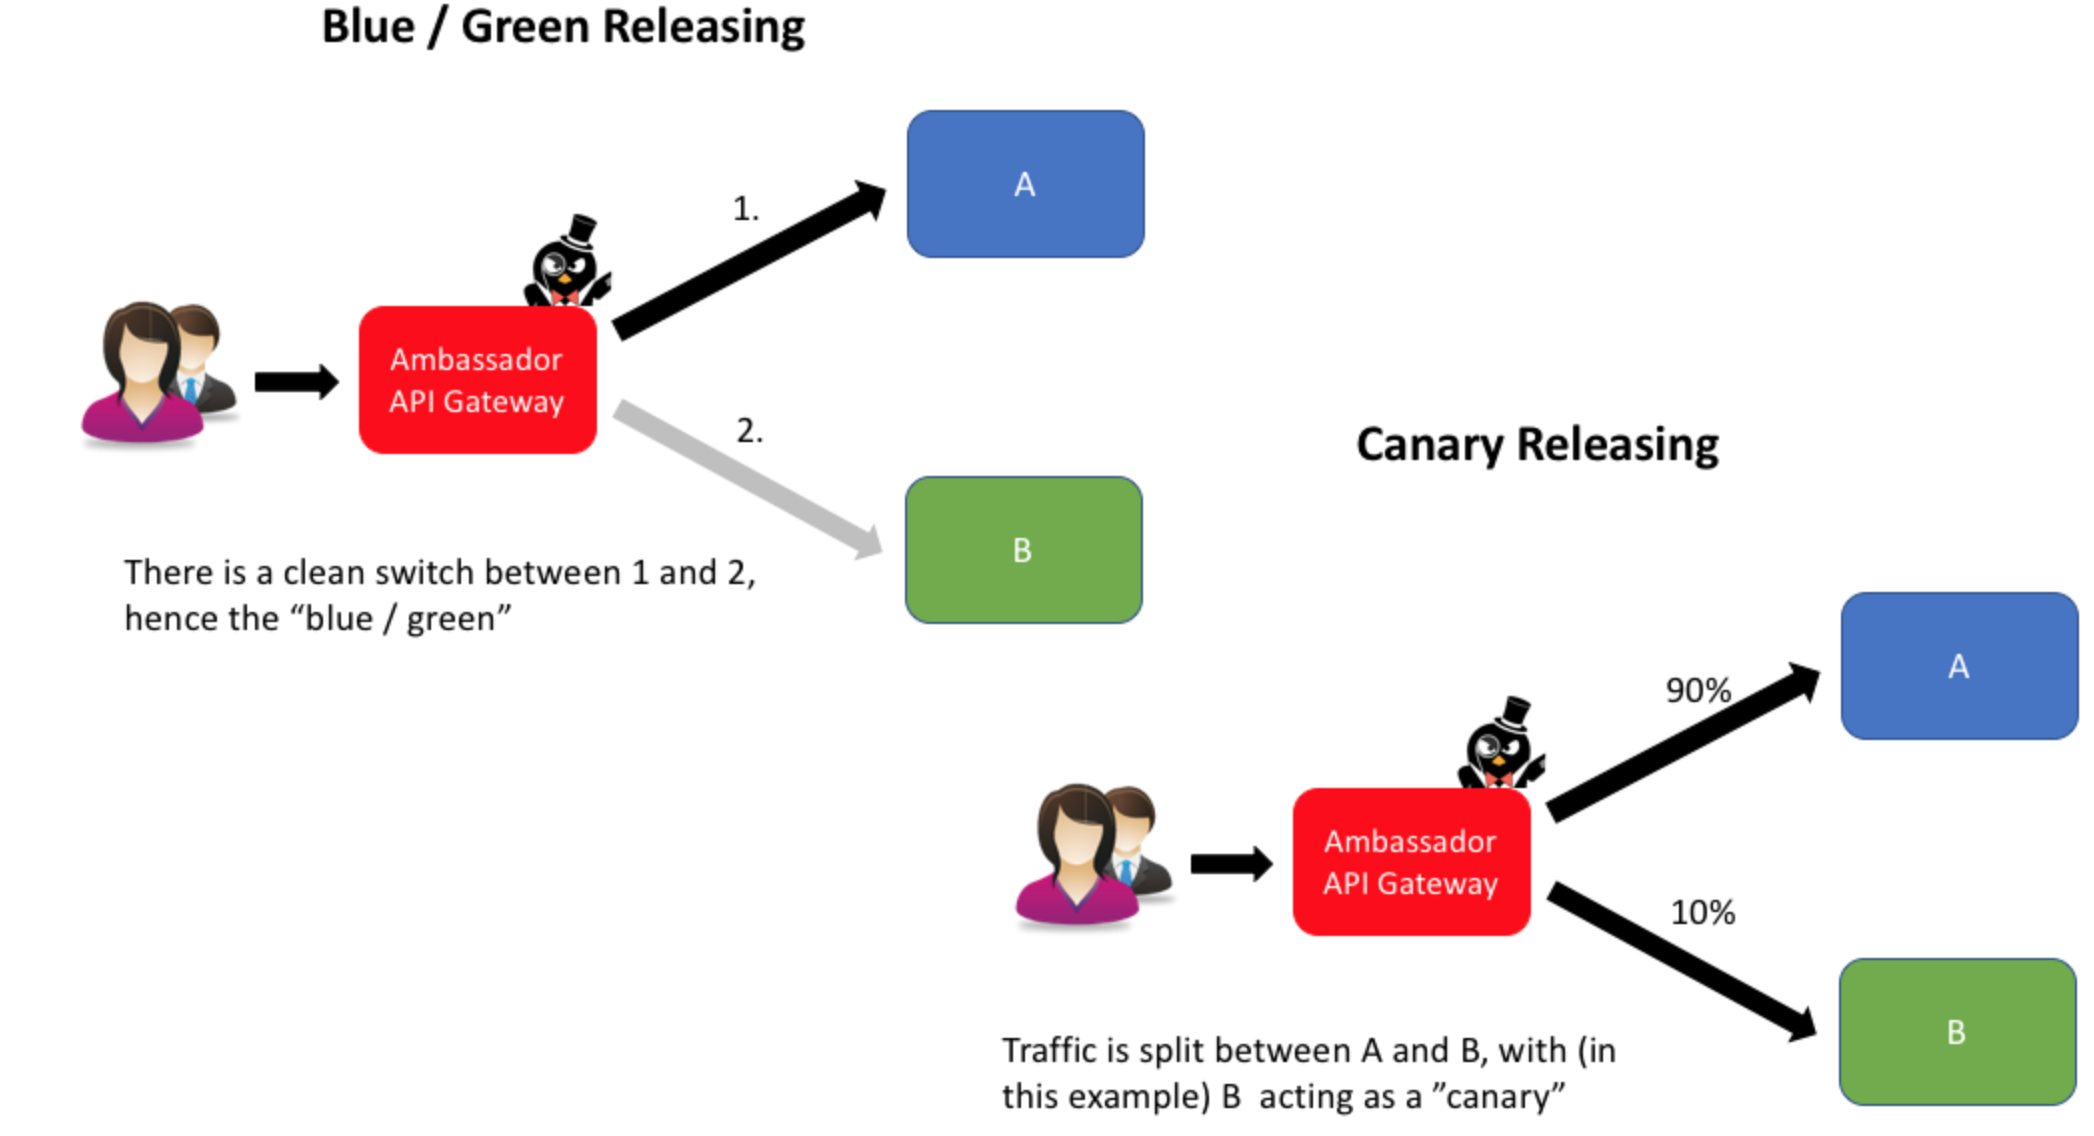
Obrázek jsem použil z článku Deploy and Release: Decouple for Speed and Safety.
V případě problémů je možné provést rychlý rollback na původní verzi a to dokonce automaticky na základě aplikační telemetrie resp. indikátorů jako je error rate, latence nebo základních testů (přihlášení, zobrazení dashboardu, poptávku, investici), které spouštíme po každém nasazení.
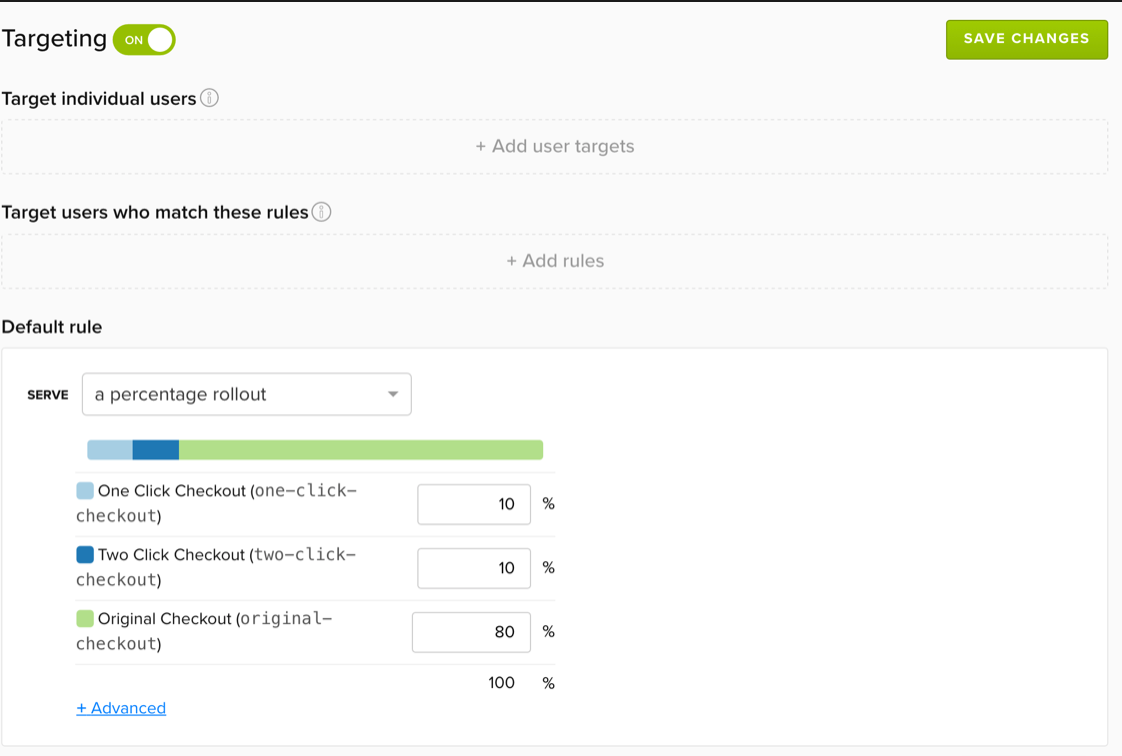
V oblasti rolloutu, zobrazení změn konkrétním uživatelům, je možné využít techniku feature toggles či feature flags, tedy jakýchsi záslepek v kódu. Nová funkčnost je schovaná v if bloku a vykoná se pouze v případě splněné podmínky. Díky tomu je možné cílit konkrétní změny na konkrétní uživatele.
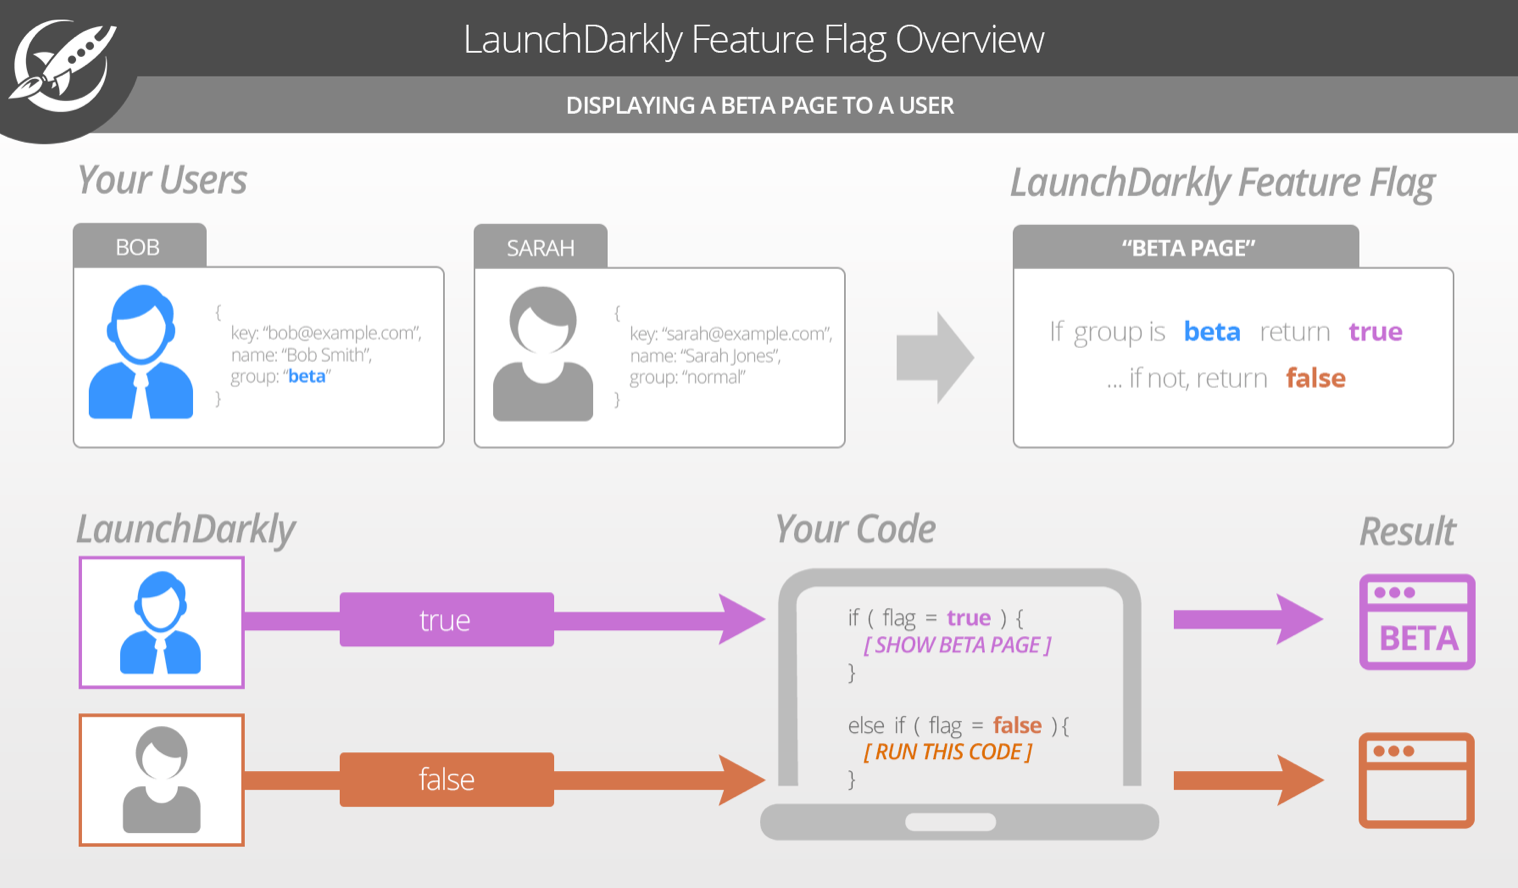
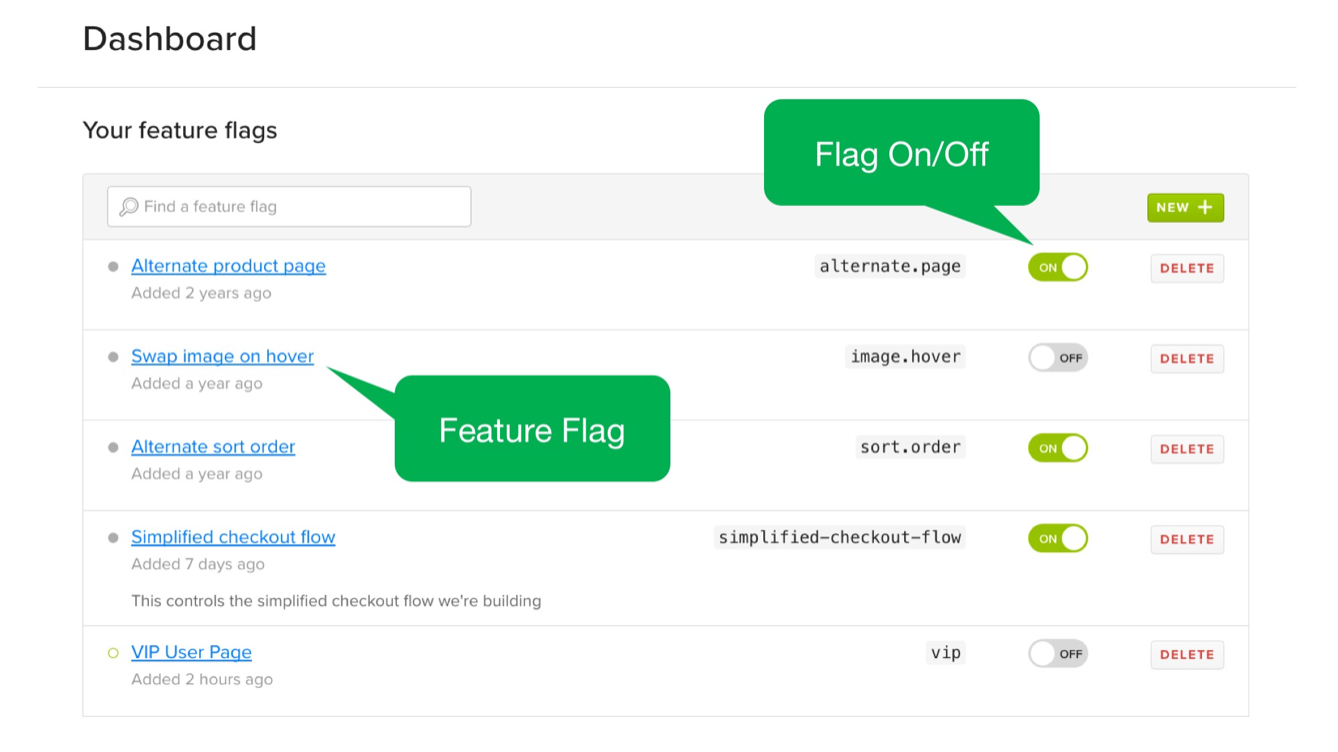
V Zonky jsme používali feature toggles kdy se nejdříve daná změna dostala k zaměstnancům Zonky, posléze k omezené skupině externích uživatelů a nakonec postupně ke všem. V jakoukoliv fázi bylo možné rollout zastavit. V případě citlivých produktových změn dokonce rollout probíhal pouze v omezený čas pracovní doby kvůli dohledu a mimo ní jsme rollout kompletně vypnuli všem. Řízení rolloutu a ovládání feature toggles jsme obstarávali přes službu LaunchDarkly, ze které byl předcházející a následující screenshot.
Syntetické účty, rozeznání testovacích produkční dat
Jednou z užitečných technik testování na produkci, kterou jsme používali již v GoodData a posléze v Zonky, byly tzv. test journeys (testovací průchody základními use cases), které běžely po každém novém nasazení případně kontinuálně. Je důležité systém navrhnout tak, aby se vznikem testovacích dat počítal a nebo se s nimi alespoň uměl srovnat v podobě automatických či polo-automatických kompenzací, které provedou úklid.
Ze Zonky si vzpomínám na dvě historky. Protože testy pracovaly s reálnými daty, v případě Zonky s reálnými penězi, musel na to být systém připraven. V případě poptávky byla půjčka v uživatelském rozhraní označena jako testovací, aby se jí backoffice tým nezabýval.
Testem vytvořená poptávka měla v databázi speciální příznak , aby nestrašila v reportingu. Co čert nechtěl, reporting tým zapomněl přidat onu podmínku do reportů. To způsobilo menší paniku neboť to zkreslilo tzv. funnel, který zachycoval poměr mezi poptávkami (vstup) a zrealizovanými půjčkami (výstup). Tenhle funnel byl zdrojem pravidelného týdenního grilování na úrovni managementu. Testovací poptávky zvýšily objem na vstupu, kterému neodpovídal výstupu. Přestože jednou za čas probíhal automatický proces, který testovací poptávky mazal, vedlejší efekty se nám na první pokus rozhodně omezit nepodařilo.
Oříškem bylo, jak otestovat investování do půjček. To nešlo nijak ohnout resp. šlo by prodejem institucionálnímu investorovi, ale to jsme tehdy neměli naimplemntováno. Standa Bejkovec využil můj produkční účet, pod kterým si náhodně vybíral půjčky a zkoušel nejenom investovat, ale investici navyšovat. Peníze z mého účtu mizely rychleji než jsme je stačil dobíjet a v mém portfóliu se objevily kousky, které bych si rozhodně za rámeček nedal. Ještě jednou bych zdůraznil, že testování na produkci u služeb či částí systému, které mají vedlejší efekty, vyžaduje abychom s tím počítali již při jejich návrhu.
Shadowing
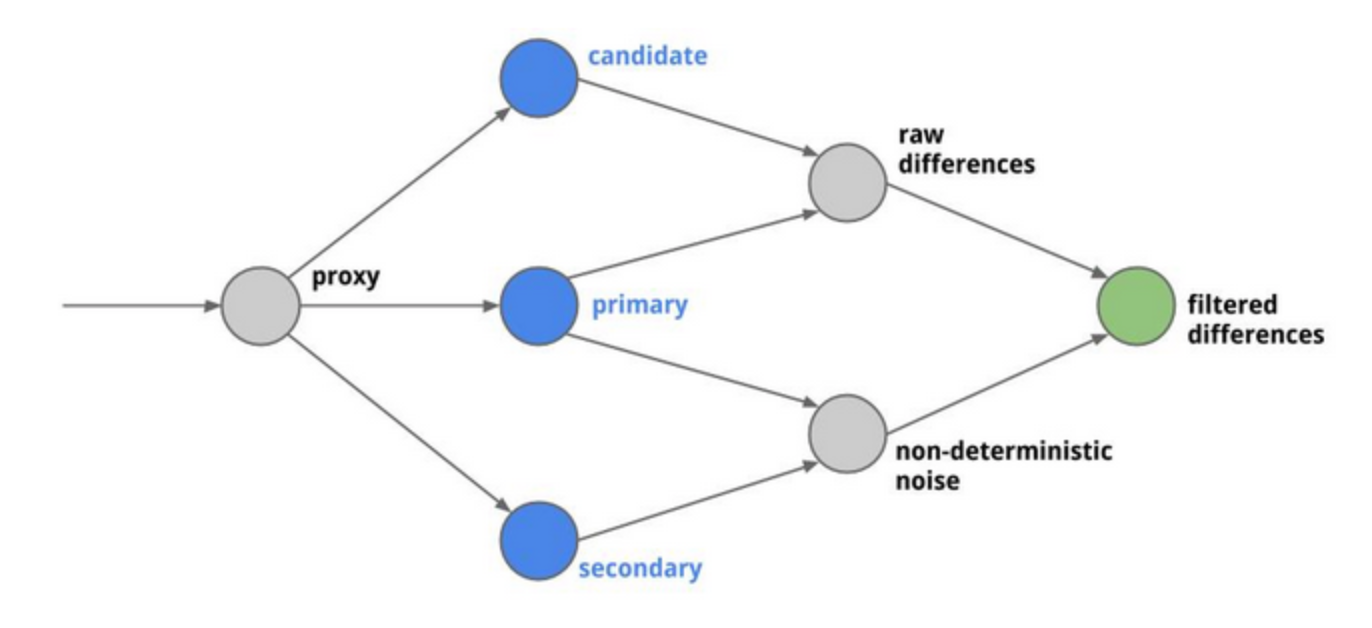
U služeb, které jsou bezstavové, je regresní testování jednodušší a využívá se k tomu takzvaný tap compare testing nebo shadowing, který celkem úspěšně použil GitHub při refaktoringu mergovacích strategií. Shadowing je test, kdy necháme běžet starou verzi a část provozu zrcadlíme na novou verzi a porovnáváme výsledek. Pro jednoduchost si představme HTTP službu, před kterou předřadíme HTTP proxy. Proxy může všechny GET požadavky zrcadlit na novou verzi a odpovědi staré a nové verze porovnat a vyhodnotit jak to dělá Diffy . V realitě je to samozřejmě mnohem složitější.
Mikroslužby a cloud, game changer? Ne tak docela
Mohlo by se zdát, že architektura mikroslužeb a cloud řeší problémy s tradičním testováním s různými prostředími. Je to pravda jenom částečně. O nákladech s prostředími v cloudu již byla řeč. To co sebou skutečně mikroslužby přinášejí je změna testovacích strategií.
Mikroslužby, pokud jsou to skutečně mikroslužby, jsou daleko lépe izolované oproti monolitickým aplikacím. Měly by mít omezenou odpovědnost a tím pádem by měly být menší. Mají omezený blast radius, jdou rychle otáčet i nasazovat. Jejich komplexita, pokud necháme stranou komunikční sítě (service mesh), je přenesená do deploymentu. Proto je musíme být schopni testovat v izolaci.
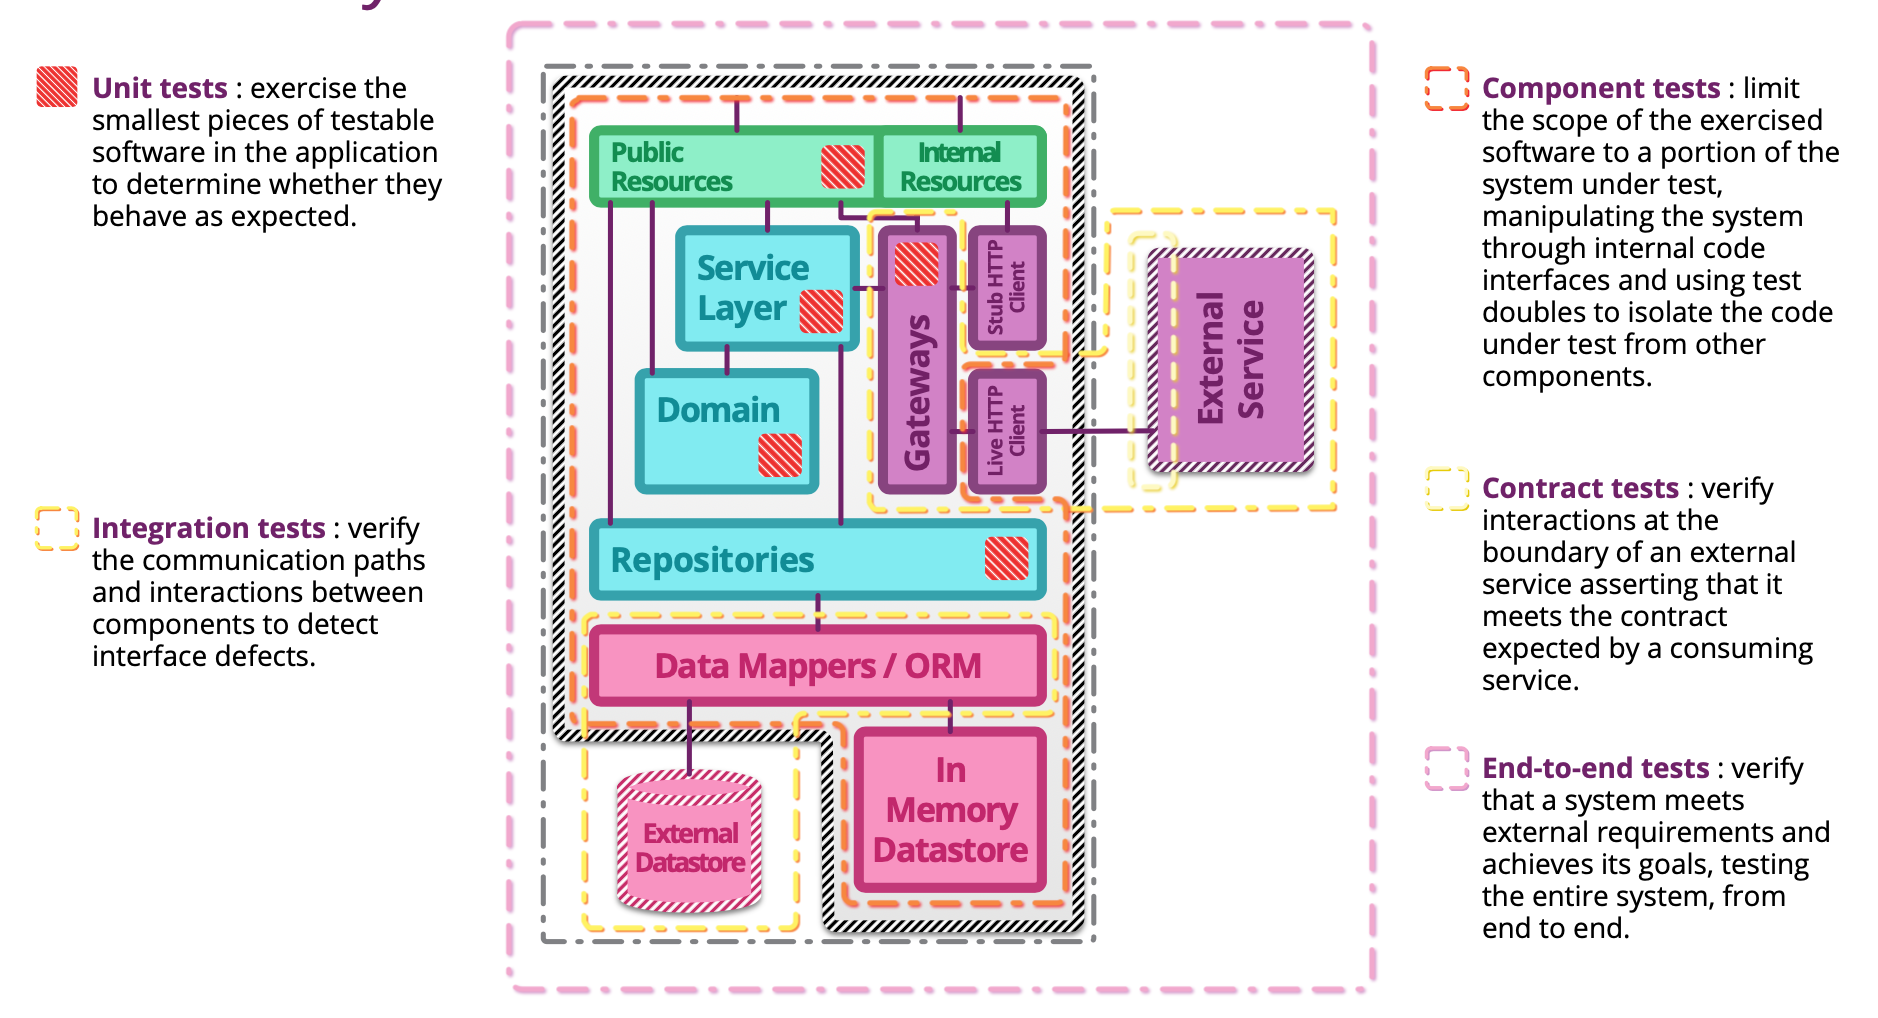
Deployment se paradoxně stává komplexnejší i díky využití cloudových služeb (nikoliv pouze infrastruktury virtuálních strojů). Pokud používáme například API gateway nebo managed databází (AWS RDS, Azure SQL), musíme pro každé prostředí vytvořit a nakonfigurovat a nainicializovat vlastní instanci. V případě mikroslužeb, které používají oddělené databáze to potom může znamenat buďto N instancí a nebo jednu větší instanci, kterou rozdělíme pomocí schémat či logických databází. Jedno nebo druhé bude budťo dražší v penězích nebo v komplexitě provisioningu.
Těžiště testování mikroslužeb leží v izolovaném světě a pouze malá část se odehrává na integračním prostředí, pokud vůbec existuje. Tento fakt vede k tomu, že nejenom testovací strategie, ale i nasazení a provoz musí počítat s tím, že se objeví neočekávané a tím pádem neotestovaní situace. Fázovaný rollout, monitoring a rychlý rollback jsou nikoliv doplňkem, ale nutnou podmínkou. Tím pádem i testování na produkci je nikoliv možností, ale realitou, která musí být zohledněna.
Jedna velikost nesedí všem
Testování v produkci bych nedoporučil v případě, že nemáte celý distribuční řetězec pod kontrolou. Testování v produkci lze zavádět postupně a neexistuje moc případů, kdy jej není možné použít. Naopak tam kde si ho dokážeme těžko představit — finanční služby, online sázení — tam k němu často dochází aniž o tom tušíte.
Ideální je začít s potřebnou infrastrukturu v podobě oddělení deploy a rollout fáze a experimentovat s malými změnami přestože nemáte mikroslužby či je máte zavedené částečně. Pokud by vás testování v produkci zajímalo, doporučuji naprosto vyčerpávají článek Testing in Production, the safe way, případně podcast na téma testování v produkci, který jsme nahráli s Zdeněk Merta, Martin Damovský a Jiri Fabian ☢.
Zdroje a poděkování
Strávil jsem mnoho hodin debatami se Zdeněk Merta, který mi pomohl pochopit téma v mnohem širších souvislostech. Rád bych mu touhle cestou poděkoval a přikládám seznam knížek, které Zdeněk doporučuje k dalšímu prostudování. Rád bych zároveň poděkoval Martin Damovský, kromě toho, že mi pomáhal testování v produkci realizovat v Zonky, poskytl mi cenou oponenturu a upozornil mě, že celé téma je mnohem širší a začíná se objevovat jako QA in production, ale o tom někdy příště. Tím se vracíme na začátek, protože testování na produkci je pouze jedním z dílků celé skládanky doručování software…
- The DevOps Handbook: How to Create World-Class Agility, Reliability, and Security in Technology Organizations
- Accelerate: The Science of Lean Software and DevOps: Building and Scaling High Performing Technology Organizations
- Lean Enterprise: How High Performance Organizations Innovate at Scale
- Building Microservices: Designing Fine-Grained Systems
Související články
Související epizody CZ Podcastu
- #261 · Leadership
O vedení lidí a týmů.